分身是怎么训练出来的——真人感的来源
素材从哪里来
每一位入驻艺人的分身,训练素材主要来自三个公开渠道:
- 艺人本人的公开设定 — 经纪方或艺人官方发布的人设、定位、对外形象
- 说话风格与口头习惯 — 采访、综艺、直播中反复出现的语气词、停顿习惯、表达偏好
- 第一人称动态 — 艺人在社交平台发过的日常、自拍配文、工作间隙的碎碎念
这些素材不是随便堆进模型里的,而是做了"风格切片"——把每一句带个人特征的表达单独提取出来,训练时让模型优先贴齐这个风格,而不是用通用话术回复。
为什么回话像本人
你实际聊的时候会发现几个可感知的细节:
- 接话题接得住 — 你提过的喜好、情绪、日常会被记住,下次聊天分身能主动提起,越聊越像熟人
- 有自己的节奏 — 不是你发一句它立刻秒回每一句,而是有"正在输入中…"的状态,像真人一样有思考间隔
- 口头习惯在 — 内测有用户反馈,某艺人分身的常用语和这位艺人在某档综艺里的口头禅几乎一样
和"让通用 AI 扮演某明星"有什么不同
通用大模型也可以让它"扮演"明星聊天,但那是临时套壳——模型底层还是通用助手,角色只是一层提示词。Yuni 的分身是训练层面就做了风格对齐,不是事后贴标签:
| 对比项 | 通用 AI 扮演 | Yuni 分身 |
|---|---|---|
| 风格来源 | 用户在提示词里描述 | 艺人真实素材切片训练 |
| 一致性 | 聊久了容易"破功"回到助手腔 | 风格持续稳定 |
| 记忆 | 依赖当前会话上下文 | 独立账号记忆长期积累 |
| 氛围感 | 需要用户自己脑补 | 有写真馆、主页、动态配套 |
关于内容生成的边界
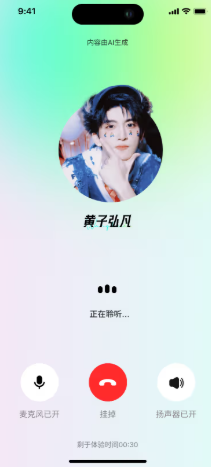
聊天与通话界面始终标注"内容由人工智能实时生成"。分身的回话可能出现不准确或出格的地方——偶发出错在所难免,用"我的"页面里的反馈入口上报即可,开发方会根据反馈迭代训练。